[Astro] #184 ブラウザだけで動く .git 解析ツール — 重い理由と、中身を、読むだけで調べる
はじめに
前回は、動画の大きさを変えて軽くするツール、Video Resize を作りました。
[Astro] #183 ブラウザだけで動く動画リサイズツール — 縦横比を保ったまま、大きさと容量を小さくする
ブラウザの中だけで動く、動画の大きさを変えて軽くするツール Video Resize を作りました。
lain-lab.com今回は、.git フォルダの中身を調べるツールです。名前は Git Inspector です。Inspector シリーズの、新しい 1 本です。
きっかけは、自分のブログのリポジトリでした。.git が約 3.9 GB あって、なぜそんなに大きいのか、分かりませんでした。手で調べると、次のことが分かりました。
- 到達できるオブジェクト(ブランチやタグからたどれるもの)は、23,664 個
- 1.12 GiB と 574.2 MiB の 2 つの大きなファイルは、ブランチやタグからはたどれず、reflog(操作の履歴)にだけ残っていた
- その 2 つは、
.git_backup/objects/pack/…という名前の、pack ファイル(別の.gitのコピーとみられる)だった
調べるのに、git rev-list --objects --all に --reflog を付けたり、verify-pack を見たりと、いくつものコマンドを組み合わせました。これを、フォルダをドロップするだけで見えるようにしたのが、このツールです。ファイルはサーバーに送られません。ブラウザの中で読むだけで、書き換えも、削除も、しません。
画面
大きいもの
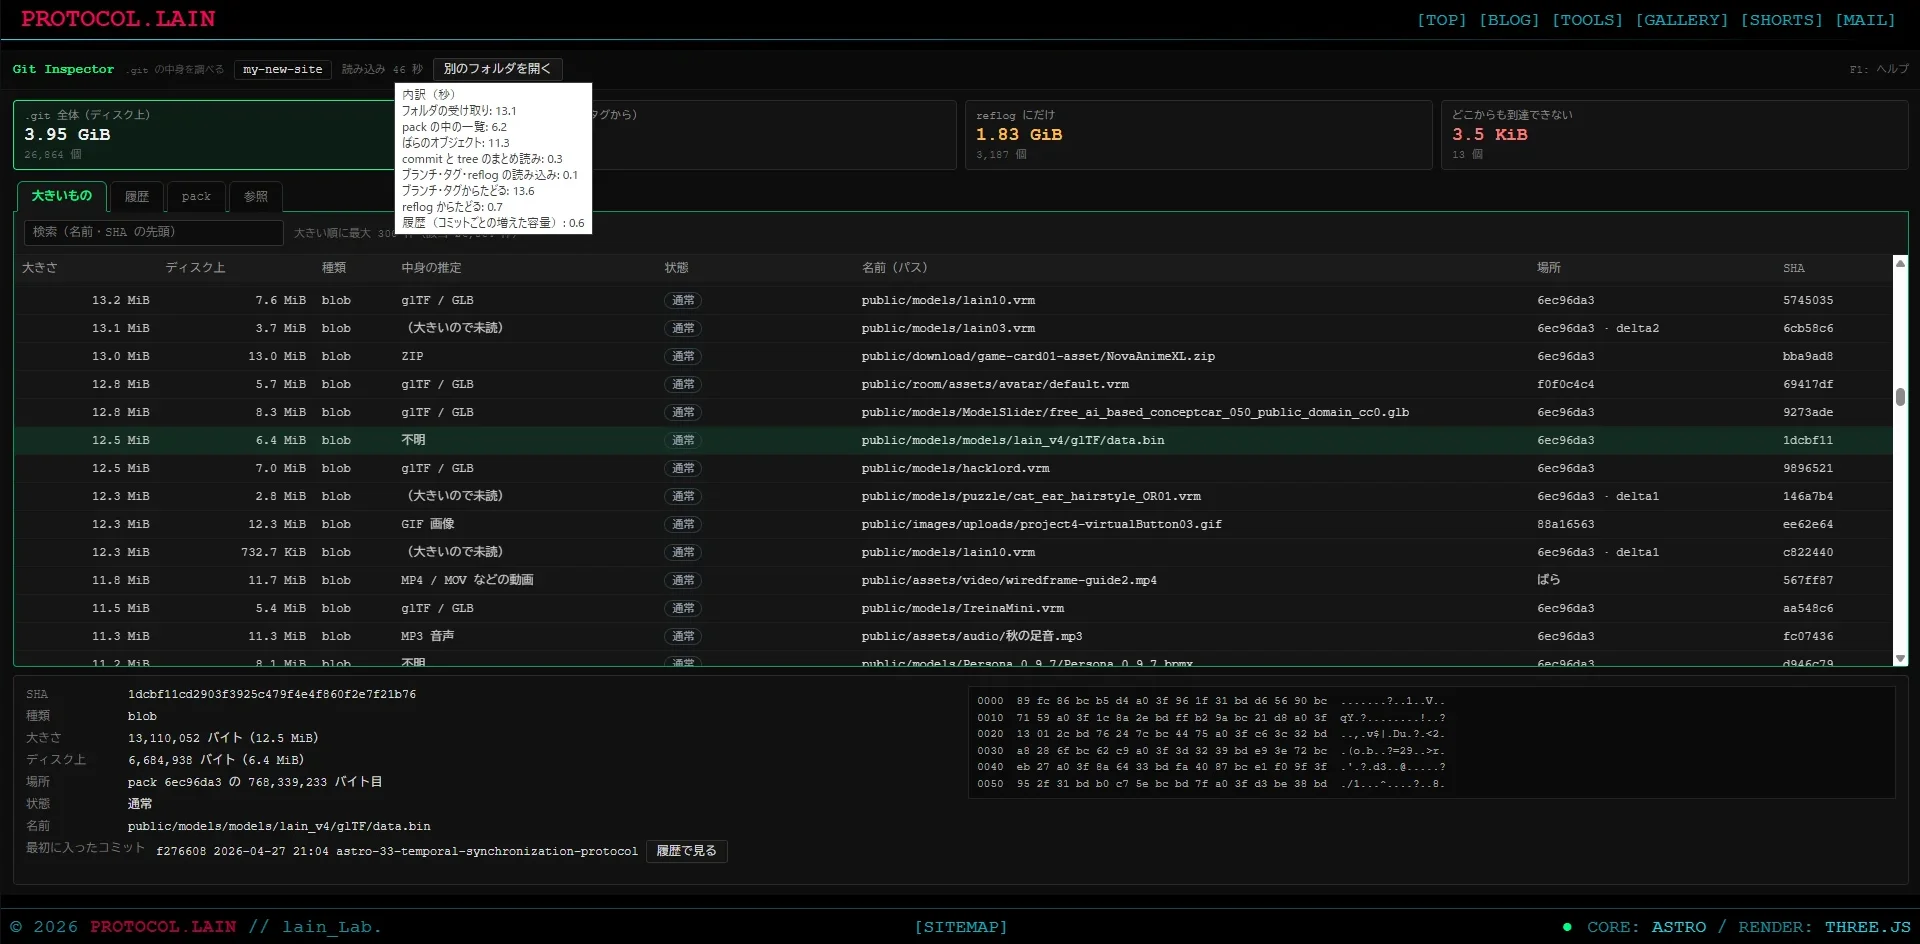
.git のあるフォルダ(または .git そのもの)をドロップすると、上に 4 つの数字が出ます。
.git全体: ディスク上の大きさと、オブジェクトの個数- 通常: ブランチやタグから、たどれるもの
- reflog にだけ: 上にはなく、reflog からならたどれるもの
- どこからも到達できない: どちらからもたどれないもの
数字をクリックすると、下の表が、その種類に絞られます。表は、大きい順です(最大 300 件)。名前(パス)、中身の推定、状態(通常 / reflog にだけ / 到達できない)が出ます。上の画面では、いちばん上の 2 行が、.git_backup の中の pack ファイルです。
履歴
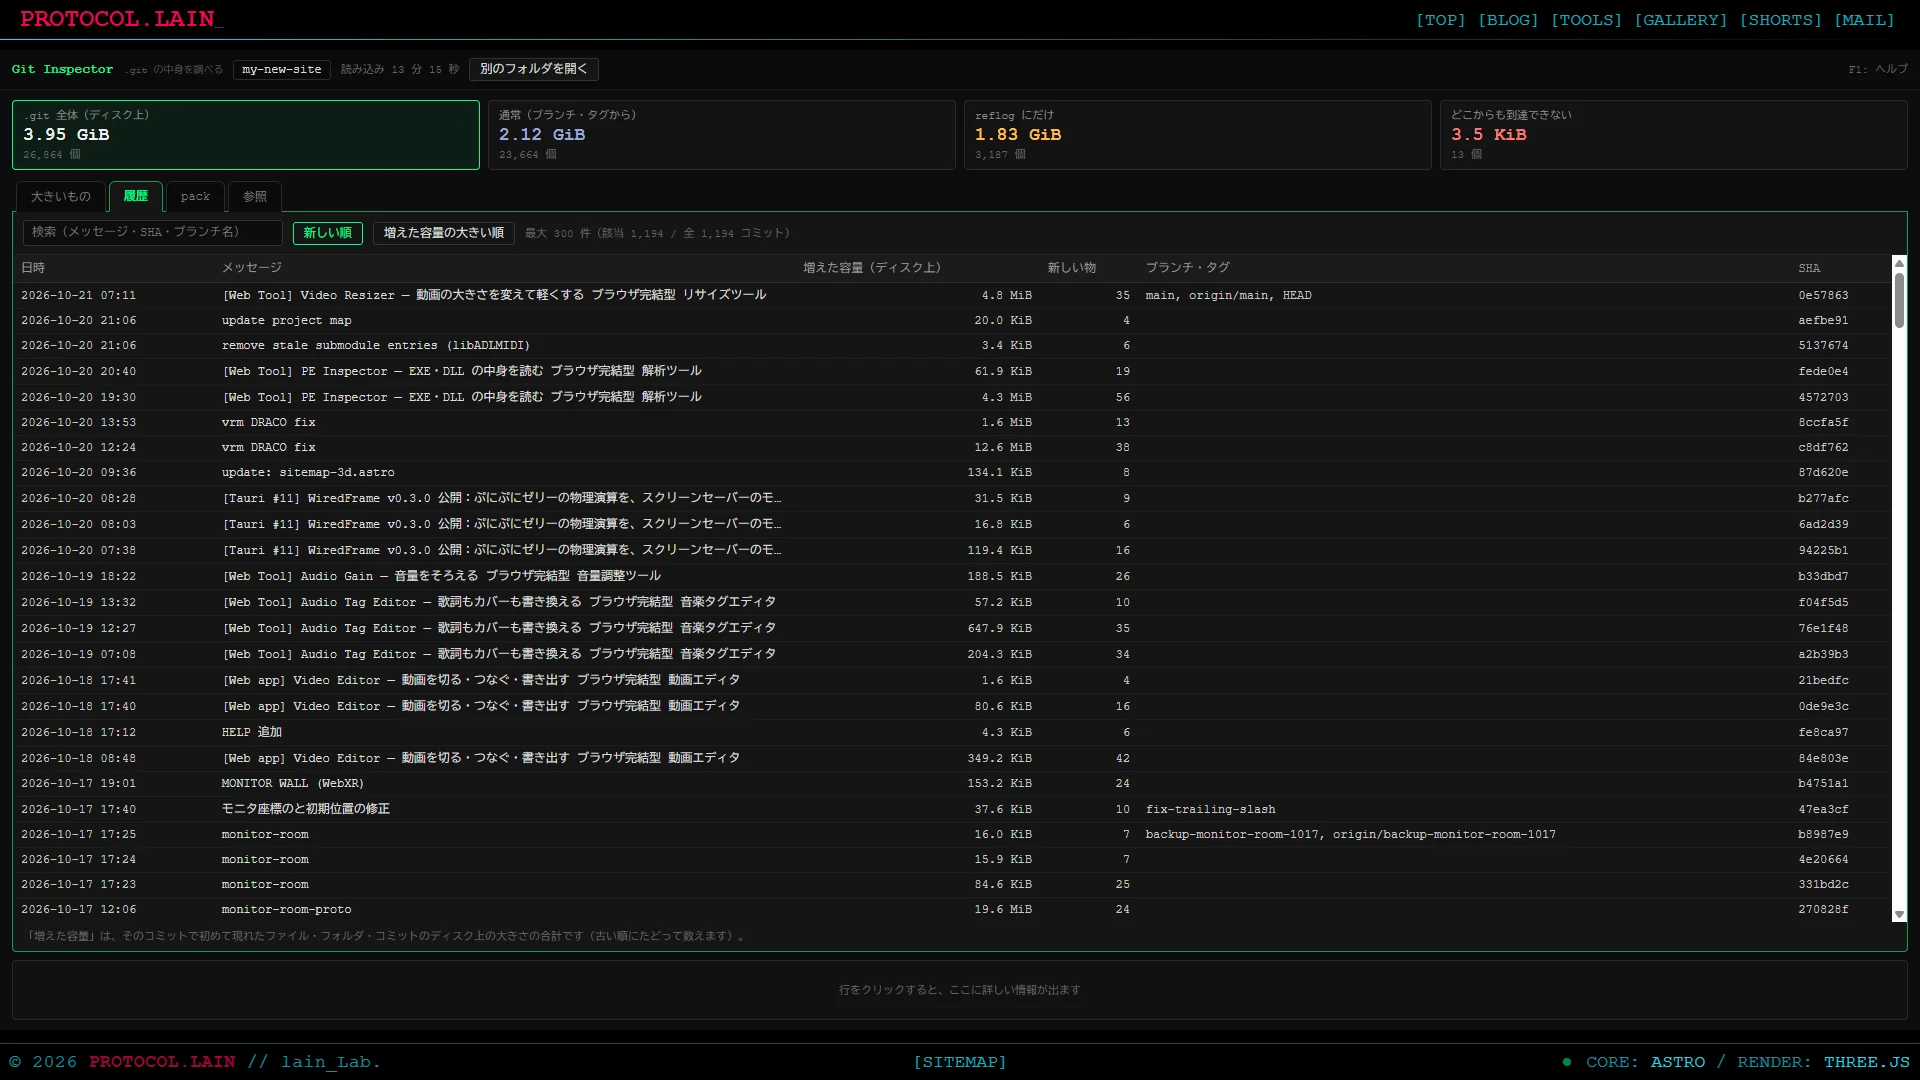
「履歴」タブは、コミットの一覧です。各コミットで初めて入ったものの大きさの合計を、「増えた容量」として出します。「増えた容量の大きい順」に並べると、.git を重くしたコミットが、上に来ます。行をクリックすると、そのコミットで入った大きいもの(上位 5 つ)が出て、クリックで「大きいもの」に飛べます。
名前のないものの中身
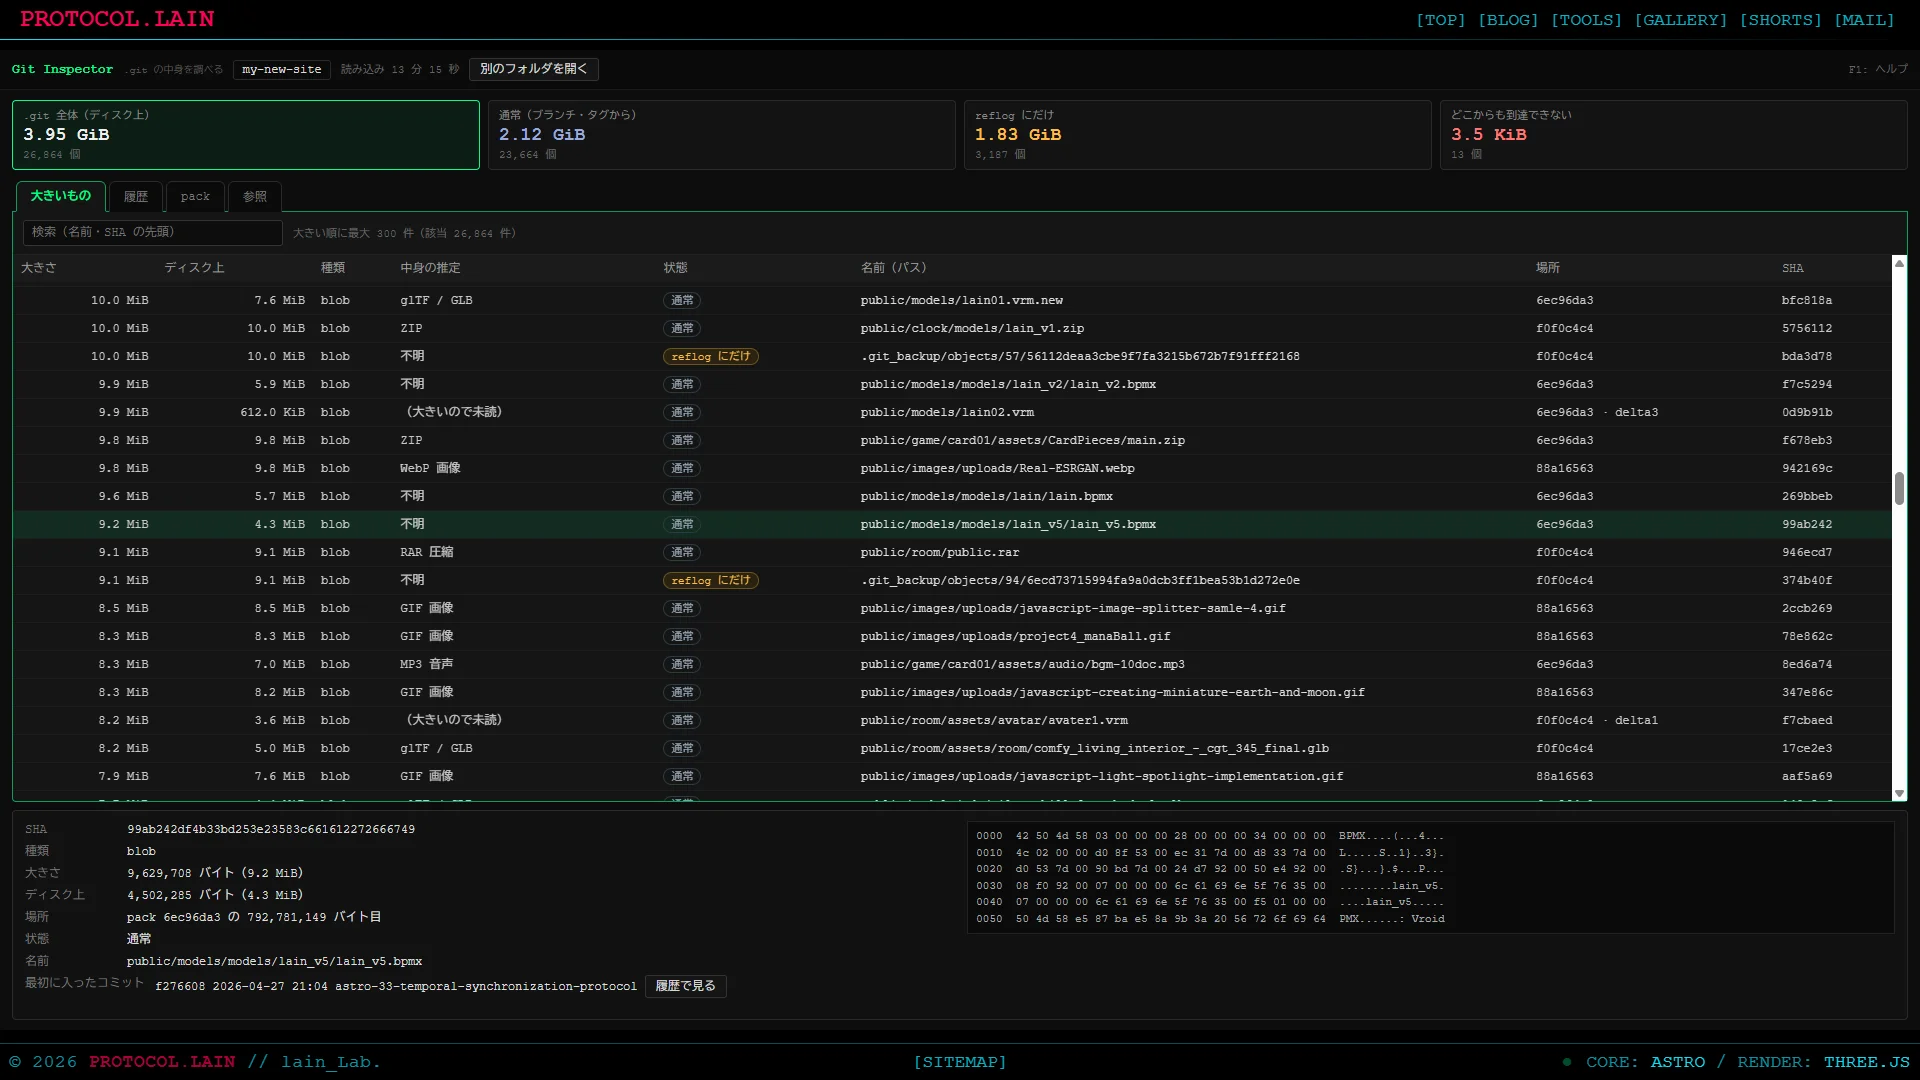
到達できないものや、commit / tree には、名前がありません。そこで、先頭の 32 バイトを読んで、「中身の推定」の列に出します(PNG、PDF、zip、glTF、Git の pack ファイルなど)。上は、自作のスクリーンセーバー WiredFrame のリポジトリです。どこからも到達できない 6,902 個(1.28 GiB)は、中身を見ると、Rust のコンパイラの出力(.rmeta、ar、PDB、COFF など)が、ほとんどでした。
F1 ヘルプ
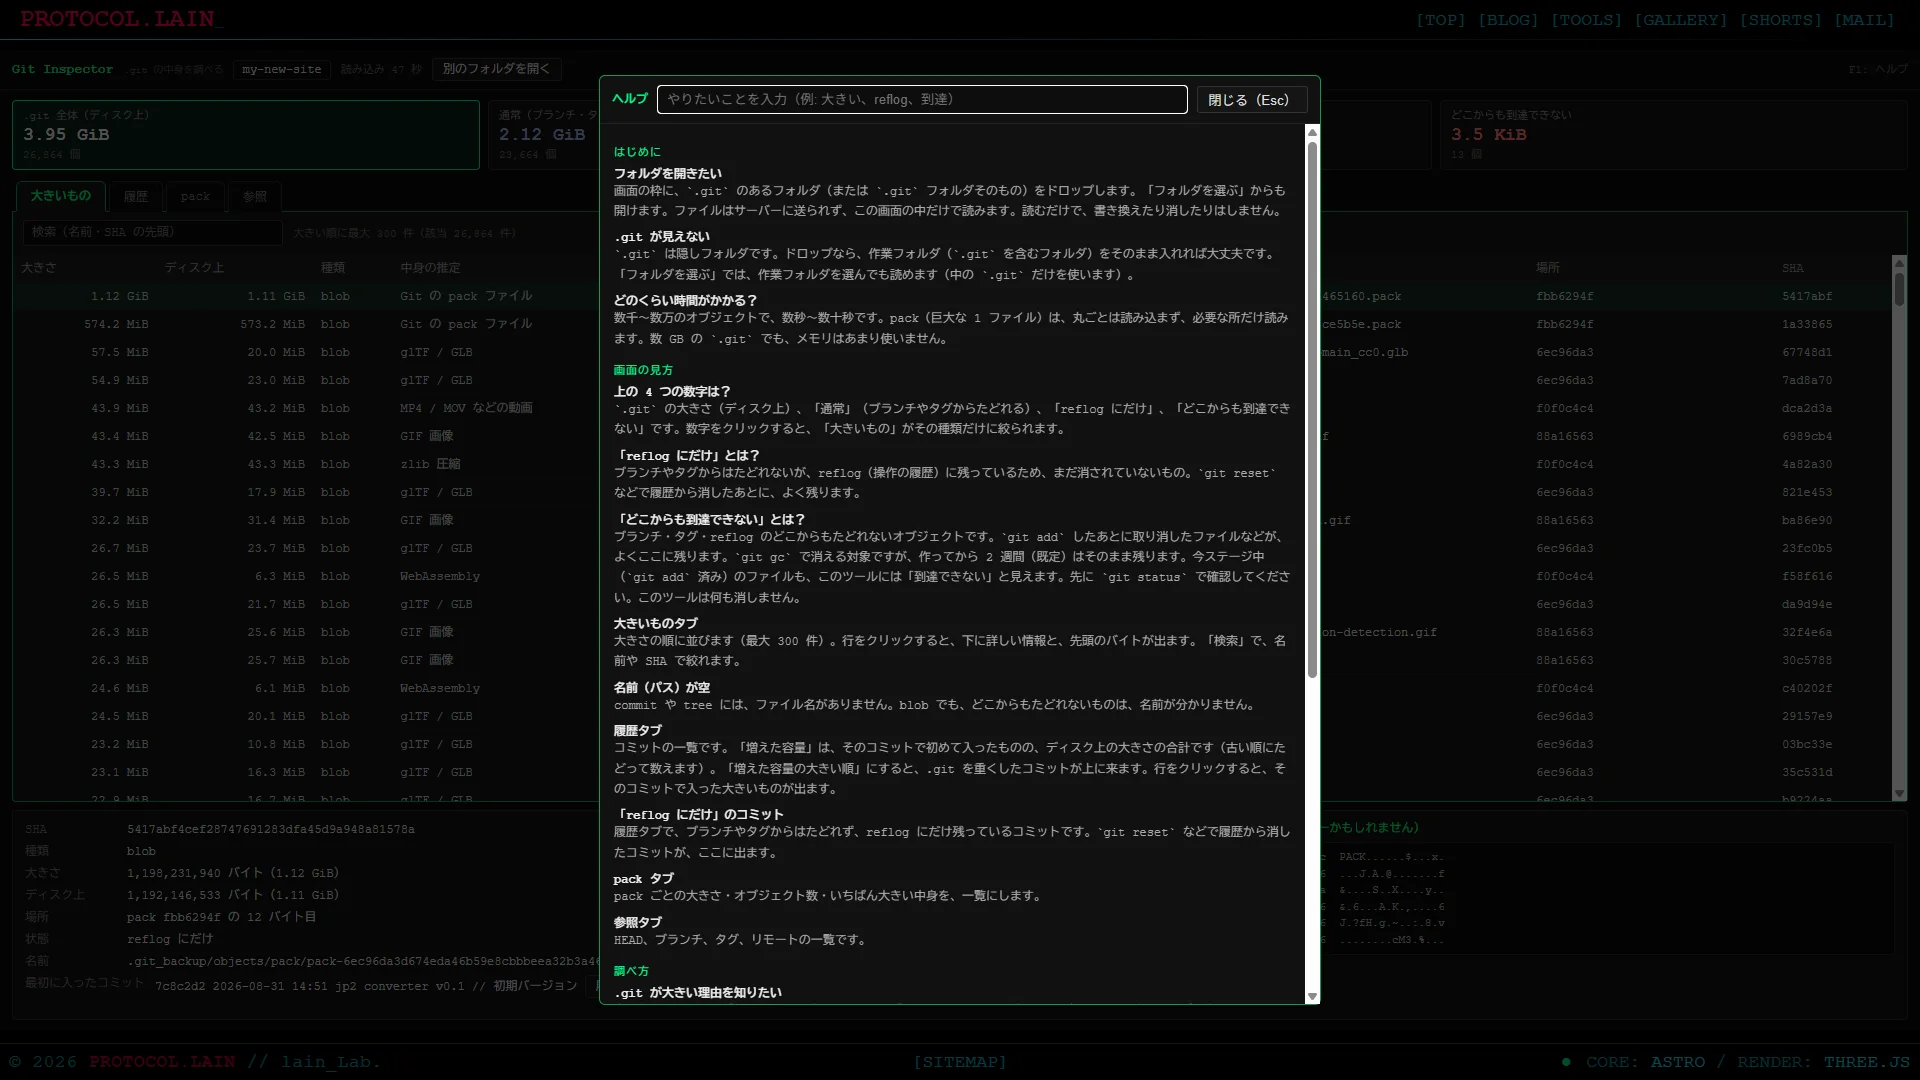
F1 キーで、使い方が出ます。「大きい」「reflog」「到達」のように、言葉で探せます。ほかのツールと同じです。
作ったもの
.gitのあるフォルダ、または.gitそのものを、ドロップか選択で読む。作業フォルダのときは、中の.gitだけを使う(node_modulesなどは数えない)- 4 つの数字(全体 / 通常 / reflog にだけ / どこからも到達できない)。クリックで絞り込み
- 大きいもの(大きい順に最大 300 件、名前・SHA で検索)、中身の推定、先頭 96 バイトの 16 進ダンプ
- 履歴(コミットごとの増えた容量、並べ替え、検索、reflog にだけ残るコミットも表示)
- pack の一覧(大きさ、個数、いちばん大きい中身)、参照(HEAD、ブランチ、タグ、リモート)
- 読み込みにかかった時間と、段階ごとの内訳
- F1 ヘルプ
画面は素の HTML・CSS・JavaScript で、外部のライブラリは使っていません。
作り方
パーサーを先に作る
最初に、画面を作らず、.git を読む部分だけを作りました。git-parser.js という、依存のない 1 ファイルです。ブラウザでも、Node 22 でも、同じコードで動きます(Node では、fs.openAsBlob でファイルを Blob として扱います)。
こうしたのは、git 本体と突き合わせて検算するためです。画面を作ってからでは、数字が合わないときに、パーサーの誤りなのか、画面の誤りなのか、分かりません。
pack を丸ごと読まない
.git の大きなものは、objects/pack/ の pack ファイルです。1 つが 1 GB を超えることもあるので、丸ごとメモリには載せません。
- 目次(idx v2)だけを読みます。先頭の 256 個の表(fanout)、SHA の並び、CRC、位置の表です。2 GB を超える位置のための 64 ビットの表も、コードにはあります
- 必要なオブジェクトだけを、
Blob.slice()で、位置を指定して読みます - 解凍は、ブラウザ標準の
DecompressionStreamです。大きなオブジェクトは、先頭だけ解凍して、そこで打ち切れます(先頭 32 バイトを見るだけなら、数 MB も読みません) - pack の中のオブジェクトは、差分(delta)で入っていることがあります。差分の元をたどって、組み立てます
ばらのオブジェクト(objects/ab/cdef…)は、1 つが 1 ファイルです。中は zlib で、先頭に「種類 大きさ\0」が付いています。
300 MB の blob が 1 個だけ入った pack(idx が 1.1 KB)で、一覧は 3 ms、先頭 32 バイトは 15 ms、メモリの増加は 3 MB でした。自分のブログの、1.1 GB の pack と同じ形です。
「到達できる」の 3 つの区分
ブランチとタグ(packed-refs、ばらの ref、別の ref を指す ref も含む)と、HEAD から、commit → tree と、順にたどります。blob の中身は読まず、tree の項目に載っている SHA だけを集めます。これが「通常」です。
reflog(logs/ の下)に出てくる SHA からも、同じようにたどります。「通常」には無くて、こちらにはあるものが、「reflog にだけ」です。どちらからもたどれないものが、「どこからも到達できない」です。
git reset で履歴から消したコミットや、コピーした .git をコミットしてしまった跡は、「reflog にだけ」に残ります。ブランチだけを見る道具では、ここが見えません。
コミットごとの増えた容量
「どのコミットで重くなったか」を出すために、コミットを、親が先になる順に並べます(同時に進められるものは、日時の古い順)。順に tree をたどって、まだ見ていないものだけを、そのコミットのものとして数えます。一度見た tree の中には、入りません。
この数え方には、git の rev-list C --not 親 と違うところがあります。枝分かれした 2 つの枝に同じファイルがあると、git は両方に数えますが、このツールは、先に数えた方にだけ付けます。一直線の履歴では、git と完全に一致します。
中身の推定
先頭の 32 バイトを見て、決めます。PNG、JPEG、GIF、WebP、PDF、zip、gzip、7z、RAR、SQLite、MP3、WAV、MP4、WebM、Ogg、wasm、glTF、Unity、EXE(MZ)、ELF、Git の pack など、30 種類ほどの判定です。
最初は、見つけられないものが多く、不明の行が並びました。実際の hex ダンプを見て、足していきました(詳しくは、「詰まったこと」に書きます)。
読み込みを速くする
自分のブログの .git(3.95 GiB、26,864 個)を最初に読み込ませたとき、13 分 15 秒かかりました。原因は、読み込みの回数でした。
自分の環境では、.git が WSL の中にあり、Windows からは \\wsl.localhost\… で見えます。ここでは、ファイルを読む 1 回ごとの待ちが長く、小さな読み込みを何万回もすると、その待ちが積み重なります。pack の中のオブジェクトを 1 つずつ読んでいたので、まさにそうなっていました。
そこで、次のように変えました。
- 近くにあるものは、まとめて読む(8 MiB までの窓。間が 512 KiB 未満なら、つなげる)
- 差分のオブジェクトは、先頭の 384 バイトを先に読んでおく(種類と、元になるものの場所が、ここで分かる)
commitとtreeは、先にまとめて読む- 差分の元(ベース)を、メモリに覚えておく。全体で 256 MiB までの枠を、共有する
どの程度まとめられるかは、先に、擬似的に遅延を入れた測定で見ました。実機で確かめたのは、そのあとです(次の「実機で確認できたこと」)。
詰まったこと
「git gc で消える」は、言い過ぎでした
ヘルプに、「どこからも到達できないものは、git gc で消える」と書いていました。実際は、作ってから 2 週間(既定)は消されませんし、ステージしている途中(git add 済み)のファイルも、このツールには「到達できない」と見えます。.git/index は読んでいないためです。ヘルプを直して、「先に git status で確認してください」と書きました。
読み込みの時間が、短く出ていました
読み込みの時間を、ツールに出すようにしました。最初に出た数字は 4.3 秒でしたが、画面を見ていた体感は、10 秒ほどでした。原因は、計り始めが、ドロップしたあとの、解析の開始だったことです。フォルダを受け取る時間が、入っていませんでした。ドロップした瞬間から計るように直すと、6.5 秒になりました。
別の確認として、自作の時計(Lain Clock)の秒針の音に合わせて、数えました。ほぼ一致しました。
不明な行が、不明でなくなるまで
最初は、Rust のコンパイラの出力が、すべて「テキスト」と判定されていて、692 MiB の「テキスト」が 1 つありました。実際のバイトを見ると、次のものでした。
!<arch>\n(ar。ライブラリ)rust\0\0\0(Rust の.rmeta)RSIC(Rust の増分コンパイルのデータ)- PDB(Microsoft の MSF 形式)
- COFF(オブジェクトファイル。先頭の機械の種類と、
.の位置で判定) - zlib(
78 01などで始まる。.git_backupのばらのオブジェクトのコピー) - ONNX(protobuf。
08 06 12 07 pytorchで始まる)
実機の hex ダンプをもらって、1 つずつ判定を足しました。WiredFrame の、どこからも到達できない 6,902 個は、この追加で、ほとんどが分かるようになりました。
それでも、まだ不明なものが残ります。lain_v4/glTF/data.bin(頂点データと思われる、浮動小数点の並び)や、.bpmx は、判定の手がかりが見つかっていません。
13 分 15 秒が終わらない、と思いました
自分のブログのリポジトリを読ませると、「履歴を調べています… 320 コミット」のまま、動いているのか止まっているのか、分からない時間が続きました。最終的に 13 分 15 秒で終わりました。結果は、手で調べた内容と一致しました。
読み方を変える前に、擬似的な測定で、「1 分ほどになるはず」と話しました。これは、言い過ぎでした。ばらのオブジェクトは、1 ファイルずつ読むしかなく、まとめられません。あとで、「確約できない」と直しました。実際は 45 秒でしたが、根拠は、擬似的な測定だけでした。
実機で確認できたこと
Windows の Chrome(localhost)で、確認しました。
- 自分のブログのリポジトリ(
.git3.95 GiB、26,864 個): 通常 2.12 GiB(23,664 個)、reflog にだけ 1.83 GiB(3,187 個)、どこからも到達できない 3.5 KiB(13 個)。最大の 2 つは、.git_backupの pack で、1.12 GiB と 574.2 MiB でした。手で調べた結果と一致しました。読み込みは、13 分 15 秒から 45 秒になりました。数字は、どちらも同じです - WiredFrame(
.git1.29 GiB、7,296 個): どこからも到達できないものが 6,902 個(1.28 GiB)。git count-objects -vHの count(6902)と、git prune -nの行数(6902)が、ツールと一致しました。git statusとgit diff --cachedは何も出なかったので、今、どこからも使われていないと言えます。履歴タブでも、どのコミットにも入っていません(最大のコミットで 5.3 MiB)。原因は、ビルドの出力(src-tauri/target)だと考えていますが、名前が残っていないので、確定はできません - 作業フォルダごとドロップしても、
.gitそのものをドロップしても、同じ結果になります
読み込みの内訳(自分のブログのリポジトリ、45.9 秒)は、次のとおりです。
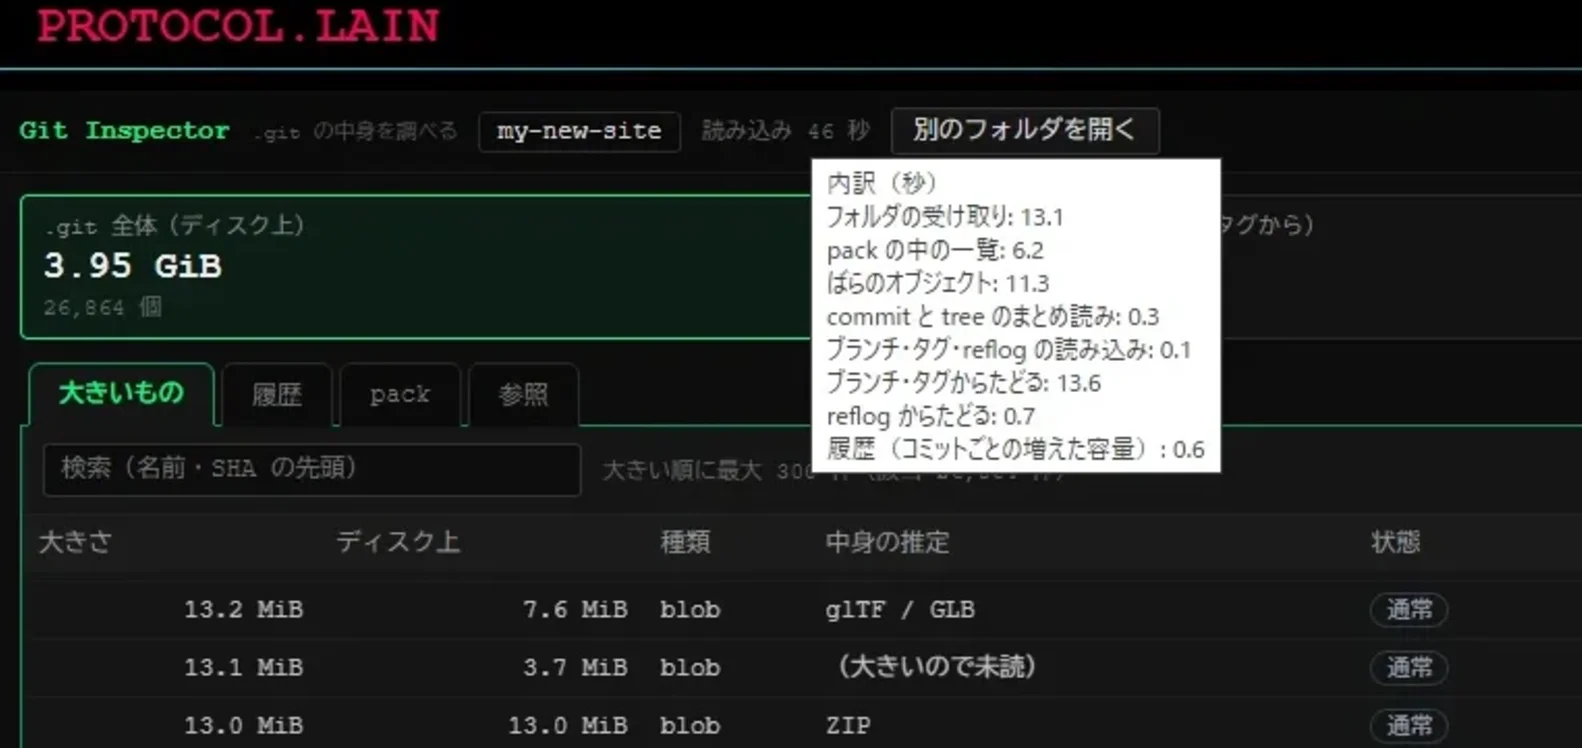
| 段階 | 秒 |
|---|---|
| フォルダの受け取り | 13.1 |
| ブランチ・タグからたどる | 13.6 |
| ばらのオブジェクト(3,127 個) | 11.3 |
| pack の中の一覧 | 6.2 |
| commit と tree のまとめ読み | 0.3 |
| reflog からたどる | 0.7 |
| 履歴 | 0.6 |
| ブランチ・タグ・reflog の読み込み | 0.1 |
13 分かかっていた部分の、大部分が、数秒以下になりました。残りの時間の多くは、ファイルを 1 つずつ読む作業と、最初にたどる作業です。
git 本体との突き合わせは、Node 22 で、次の 4 つのリポジトリで行いました(docs/git-inspector-parser.test.mjs)。
- 合成リポジトリ(差分 112 件、最大の深さ 18、pack 2 つ、ばらのオブジェクト、注釈付きタグ、reflog にだけ残るコミット)
- chalk(1,756 個、差分 859 件、最大の深さ 27。コミット 387 個、merge 21 個)
- Spoon-Knife
- 画面確認用の小さなリポジトリ
次の項目が、すべて一致しました。
verify-pack -vの全件(種類・大きさ・pack 内の大きさ・位置・深さ・元の SHA)cat-file --batch-all-objects(pack とばらのオブジェクトの全件)- 中身を読んで SHA-1 を計算し直した値が、名前と一致する(差分を正しく組み立てられた証拠)
for-each-refと HEADrev-list --objects --all(--reflog付きも)- コミットの集合(
rev-list --all --reflog)。親が子より先に並ぶこと。増えた容量の合計が、割り当てたものの大きさの合計と一致すること。一直線の履歴は、コミットごとの集合も完全に一致します
未確認のこと・制限
- ウィンドウで開いたとき(
?embed)の見た目は、まだ確かめていません - 画面が狭いとき(スマホ)は、確かめていません。専用の設計も、していません
- Chrome 以外(Firefox、Safari)は、確かめていません
- 2 GB を超える pack は、コードはありますが、試していません。idx v1 も、同じです
- shallow clone(親のないコミット)と、コミットが数万〜数十万ある履歴も、試していません。一覧は 300 件までの表示です
- worktree や submodule の
.git(フォルダではなく、ファイル)は、読めない旨のエラーを出します - 読み込みの時間(45 秒)は、1 回の実機の結果です。OS のキャッシュが効いている可能性もあり、環境によって変わります
- 名前(パス)は、同じ内容が複数の名前を持つとき、git と違う名前を出すことがあります(chalk で 7 件。集合は一致)
- 枝分かれした履歴の「増えた容量」は、git の数え方と違います(先に数えた方だけに付きます)
- ステージ中の(
git add済みの)ファイルは、「到達できない」に見えます - このツールは、見るだけです。消す作業(reflog の期限切れ、
git gc、git prune)は、しません。実行する前に、このツールで中身を確かめて、git statusも見てください - 中身の推定は、先頭 32 バイトだけの判定です。判定できなければ、「不明」になります
おわりに
「.git が重い理由を知りたい」だけのつもりが、「到達できるとは何か」「同じものを、どのコミットで数えるか」「何を読むと、どれだけ時間がかかるか」と、.git の作りを、順に学ぶことになりました。
13 分 15 秒が 45 秒になったのは、計算を賢くしたからではなく、読む回数を減らしたからでした。WSL の遅さではなく、小さな読み込みを数万回していた、こちらの作り方の問題でした。
作った本人が、スクリーンショットを見て、気づくことも多くありました。「不明」が並ぶ画面を見て、実際のバイトを見て、判定を足す。この繰り返しは、WASM Inspector や PE Inspector で、構造を読んで確かめるやり方と、同じでした。